教育部學術倫理電子報
生成式人工智慧(AI)快速的普及,為教育與研究場域帶來了明顯的影響,使高等教育與學術社群必須重新檢視知識產生與驗證的方式,本期主題文章提出「合情、合理、合法」的善用AI使用框架,此架構旨在協助學習者與研究者理解自身使用AI的需求,並在現行規範下維持必要的透明度與誠信原則。第二部分「中心新訊」回顧近期 AREE 更新內容,包括:上架 5 集 Podcast 廣播節目、新增 2 部情境影片、新增 2 主題之議題教材包、擴充領域辭典、上架 1 本教育電子書、擴充測驗題庫,新訊請點此查看。
學術誠信 2.0:AI 在教學研的轉化與回應
前言
自2022年11月底ChatGPT問世以來,生成式人工智慧(AI)已迅速成為全球矚目的AI服務,當時推出僅兩個月便擁有上億的使用者。生成式AI快速全面的普及,也為教育與研究場域帶來了明顯的衝擊,包括學生的學習、研究與寫作等,使高等教育與學術社群必須重新檢視知識產生與驗證的方式。
由於生成式AI模型具備流暢生成文本的能力,但常欠缺來源追蹤、推論可靠度與事實驗證機制,本文首先說明生成式AI的基本技術特性,包括其可能產生錯誤內容的原因,以及這些現象如何直接影響學術引用、推論與資料使用的正確性。接著,本文剖析生成式AI對學術誠信造成的關鍵挑戰。學術誠信的核心問題不單是禁用與否,而必須面對現今在AI趨勢下使用情境如何維持學術責任與研究產出的可驗證性。
基於上述現況,本文提出「合情、合理、合法」的善用AI使用框架,此架構旨在協助學習者與研究者理解自身使用AI的需求,並在現行規範下維持必要的透明度與誠信原則。本文期望此框架可供各級教育者、學習者與研究人員作為參考依據,使我們在AI技術成為日常工具的條件下,仍能持續進行有責任、具學術價值的知識實踐,讓學術社群在AI環境中維持誠信與可靠性的行動準則。
一、生成式AI的技術基礎與潛在倫理風險
(一)訓練資料與時效性
任何一個大型語言模型在開發過程中,必須收集大量資料,再利用這些資料進行模型訓練。這個訓練過程需要非常多的資料、清洗與運算時間,可能長達數週甚至數月,而且是在訓練開始前就已經收集完成。而這些訓練資料來源跨越一般網路文本(如Wikipedia、Common Crawl)、公開論壇與社群媒體內容,以及授權或合作取得的資料集。有些模型會加入特定領域的文獻,例如醫學(PubMed)、法律案例彙編或教科書等,但其比例因模型與公司政策而異,未必涵蓋完整的專業資料庫。
這些訓練資料在使用前會經過清理程序,包括移除明顯重複、垃圾資訊、格式錯誤與部分敏感內容。不過,由於資料規模龐大,資料清洗的品質控管多以啟發式規則與自動化工具為主,因此仍可能保留噪音或偏誤,並無法達到完全乾淨或無錯誤的狀態(Yu et al., 2024; Chen et al., 2024)。而模型在發布當下所具備的知識,其實是「訓練資料當時世界的樣子」,而不是引擎發布時的最新狀況。換言之,模型的內部知識是隨著訓練而被「凍結」起來的,無法像搜尋引擎一樣即時更新。故而當使用者詢問發生在訓練資料時點之後的事件,例如最新法規、當下最新事件或剛出現的術語,模型的反應可能會出現兩種情況:1.直接告訴你它不知道,因為資料時間不涵蓋。2.根據語言模式來生成推測答案,卻因此產生虛構或不正確的內容,或稱為AI幻覺。這些現象的發生是因為它只能依訓練時的資料來進行回答,無法確認資訊的真實性。因此,瞭解模型的資料時間範圍與每個模型發布的時間落差,是負責任使用AI的第一步。
(二)詞彙表與資料偏差
AI在理解與生成文本時,仰賴一個巨大的拼圖庫,也就是由詞元(token)構成的詞彙表。每個詞元是一塊拼圖,其分割的語言單位可能是單字、字根、子詞、標點或單一字母,並非人類理解的「單詞」。當使用者輸入一段文字,系統會將其切分為詞元,再根據詞彙表中的編碼轉換成對應向量值,以送入深度神經網路模型中進行處理。當模型生成回應時,會依據語言模式與上下文逐一預測下一個最有可能出現的詞元,這個過程會反覆進行,直到完整生成內容。生成式AI的詞彙可能涉及以下資料倫理問題:
若訓練資料本身含有偏見(性別、族群、國籍、階級等),詞元統計分布會放大既有偏見,使模型可能生成不公平或刻板化的內容。
若資料集中某些語言或文化的文本比例低,詞彙表與語言模式將反映這種不對稱,使模型在處理弱勢語言或文化內容時產生理解困難或失真。
由於詞彙表隨模型訓練有其時間限制,新興詞彙、科技術語或流行語無法即時納入,使模型面對最新語言使用時的表現受限。
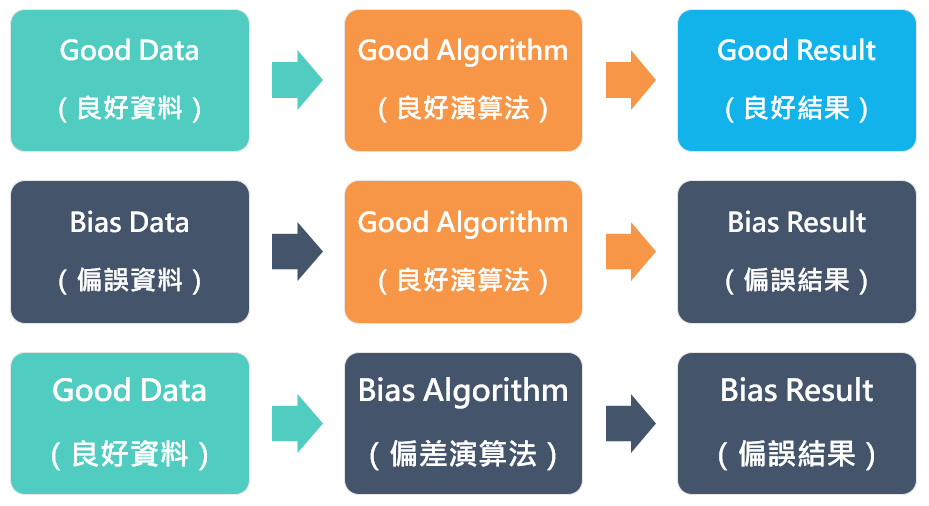
在理解生成式AI的偏差來源時,我們常會從「資料」與「演算法」兩個方向來看它的產出品質。因為生成式AI是透過大量資料學習語言規律,再由演算法決定如何組合這些規律,所以這兩者的組合方式,會直接影響模型給出的內容是否可靠。以下三種情境,說明AI可能呈現的不同結果(如圖1)。
情況一:資料品質良好,模型設計也合宜。是指當訓練資料具有多樣性、可信度高、噪音較少,而且模型在設計時兼顧語言特性、數值穩定與風險控管機制時,AI生成的內容通常較為合理。這並不表示模型絕對正確,而是它的學習素材和學習方式都比較健全,因此在面對一般知識、基礎科學或常見語言使用情境時,其輸出較接近人類可接受的品質。
情況二:資料本身有偏差,演算法沒有問題。這類問題在AI倫理中被討論最頻繁,也最具代表性。若訓練資料中某些族群語料比例過低、網路文本充滿刻板印象,或某些語言與文化的呈現不對稱,即使演算法設計得再良好,模型仍可能生成帶有偏差的回應。這是因為模型的語言模式,直接反映資料中的分布與偏見。結果會導致AI在回應中不自覺強化主流文化觀點,忽略弱勢語言,甚至重複社會中的歧視語句。此情況提醒我們:偏差常不是演算法造成的,而是世界本身的資料就不均衡。
情況三:資料良好,但演算法的設計帶來偏差。這種偏差通常源自技術選擇,而不是資料本身。例如:詞元設計方式無法良好處理某些語言,使得模型在面對這些語言時表現不佳;或者在生成策略上,演算法傾向挑選最常見的回應,使較少見的文化表達被自動忽略。此外,風險控管與內容審查機制若設計得太嚴或太鬆,也可能影響AI的回應方向。即便資料來源多元完整,若模型的內部機制無法有效利用這些資料,產出的內容依然可能偏向特定表述方式。
美國白宮前技術長Megan Smith(The White House, 2016)指出,資料與演算法系統的偏差往往源自資料缺漏、變項選取不足或模型邏輯設計的不周延。即便演算法本身運作正常,只要資料來源過度單一,產生的模式仍可能無法反映真實社會,甚至將特定價值觀或刻板印象固定化,從而忽略多元價值。
綜合來看,生成式AI的輸出結果,是「資料」與「演算法」共同作用的結果。資料偏差會讓模型學到不完整的世界樣貌;演算法偏差則會讓模型即使擁有良好資料,仍無法呈現公平多元的內容。正因如此,在教育與學術研究中,瞭解這兩種偏差的來源,是使用生成式AI時維持判斷力的重要基礎。
圖1 AI運作模式與生成結果
資料來源:作者自行整理。
二、生成式AI對學術誠信的三項挑戰
生成式AI的運作涉及資料收集與整理、模型訓練、推論生成等層面,因此其使用自然牽動多重倫理討論。首先,在資料倫理上,需關注詞彙表建立、資料來源多元性以及偏差再製的風險。其次,演算法倫理涵蓋模型架構設計、微調策略、內容審查機制,以及開發者如何處理不當內容。再者,資訊倫理涉及使用者的AI素養,包括辨識虛假資訊、理解個資風險與評估AI的可信度。同時,研究倫理關注AI在研究流程中的角色,例如是否影響研究透明度與研究受試者的權益。最後,學術倫理則聚焦AI與知識產出之間的界線問題,包括引用方式、原創性與可驗證性。本文即以學術倫理視角作為後續介紹的重點。
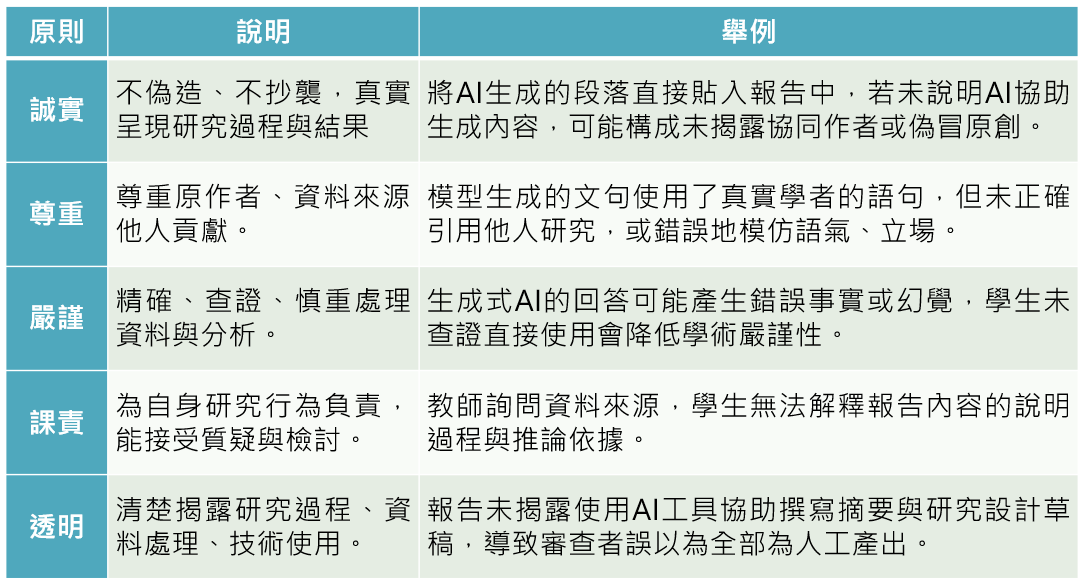
由台灣聯合大學系統編纂之《臺灣研究誠信守則》,為研究人員與參與計畫的相關人員提供了從事研究應依循的行為守則。隨著生成式AI的興起與快速普及,學術研究與知識詮釋的產出方式正經歷深刻變革,《臺灣研究誠信守則》裡所定義的「誠實、尊重、嚴謹、課責、透明」五項原則,正是研究者工作信條的基礎。然而知識產生的方式、資料處理的過程與論述建構的方法皆因現今生成式AI的普及帶來了大幅改變,亦使這五項原則的實踐面臨新的挑戰。例如,AI生成內容的「真實來源」不易追溯,使誠實與透明面臨風險;模型輸出可能混合不同語境的資訊,使嚴謹性受到考驗;若研究者未揭露AI介入程度,則課責與尊重(例如對原著作者、受試者、資料提供者)亦可能受到影響(如表1)。
表1 生成式AI對學術誠信原則的影響
資料來源:作者自行整理。
這些考驗為教育與研究的學術誠信帶來的挑戰包括:
在生成式AI已成為寫作工具的情況下,原創性的判斷出現新的模糊帶。許多使用者的確自行完成初稿,但在最後階段交由AI進行潤飾或重寫,使文本呈現明顯的AI語氣或句型。這類「人機共作」原意並非有意抄襲,但若未清楚揭露AI介入程度,外觀上容易被誤認為完全由AI生成,也使作品中「哪些部分屬於作者、哪些部分由工具加工」的界線不再明確。這正是AI時代學術誠信所面臨的首要挑戰之一。
生成式AI可能產生看似合理但實際不存在的文獻,也就是幻覺引用(Ji et al., 2023),或錯誤整合不同研究的內容。若使用者缺乏查核能力,可能直接採用錯誤資訊,導致引用失真、資料解讀偏差,甚至在專業研究中影響研究結果的可靠度。這種依AI、卻不依來源的習慣,將使學習者忽略文獻查證、比較與批判閱讀等核心學術能力。
傳統以寫作成果判定能力的方法,難以區分哪些內容由AI協助產生。現行AI偵測工具雖然廣泛使用,但研究已指出其誤判率偏高(OpenAI, 2024),甚至可能對非母語者產生歧視性誤判。這使教師在評量時面臨困難:過度依賴偵測工具會傷害學生的正當權益,而缺乏明確規範又可能讓評量標準失去一致性。
生成式AI改變了教育與研究的歷程,亦考驗著學術誠信的內涵與實踐方式。面對這些挑戰,建立明確揭露、查證與負責任使用的原則與規範,已是教育圈、學術社群甚至是整體社會接下來不可迴避的關鍵任務。
三、對於生成式AI的多層次回應與法規建構
(一)個人層次:識別與改善AI生成文本的特徵
使用生成式AI的過程中,不管是學生、教師或研究相關人員,都應具備基本辨識AI文本的能力,並主動修正這些特徵,以確保生成的結果符合嚴謹、誠實及具備個人洞見的基本要求。以下介紹六項生成式AI產出文本的常見特徵,以及相對應的改善方向。
由於模型依賴機率選取常見語言模式,容易生成重複句型或模板式結尾,例如在開頭、轉折、結尾套用「整體而言,這是一項值得進一步探索的主題」等類似句式。使用者可改寫句式、調整語氣,避免過度制式的段落結構,使內容更符合人類自然寫作風格。
AI模型傾向呈現中性敘述,以避免偏頗,因此生成內容常缺乏明確觀點,例如「有些人支持此政策,認為它能促進發展;也有人反對,擔心會產生副作用」。使用者可嘗試提出更明確的主張與理由,並對於對立觀點有所回應與評析,使文本具體且具備作者思考軌跡。
AI模型為降低錯誤風險,常會使用「可能、大多數、相對來說」等模糊詞語,例如「這項技術可能在未來某些領域產生一定程度的影響」。使用者可加入具體條件、例證或參考來源,像是「在A條件下,將會產生B影響」,使論述更具實證基礎與增加文本的說服力。
AI模型非人類不具實際生命體驗,其生成回答內容多為第三人稱且廣泛、概括,缺少第一人稱的故事與細節。故使用者可以加入個人觀點、經驗或具體案例,使內容更具可信性與真實感。
AI模型透過大量語言資料學習常見模式,因此傾向生成安全、常見或平均化的結論,常符合大眾預期,不太會生成出人意料或具衝突性的結論。使用者可加入反思性問題、批判性觀點或具有挑戰性的問題視角,使論述具不同層次的思考,內容將更具價值。
AI是大型語言模型,並非資料庫查詢系統,其引用往往來自語言模式組合而非真實查詢結果,故可能產出虛構來源或模糊的出處名稱。使用者必須逐項查證文獻的存在,確認能否在搜尋引擎或其他可靠來源查到該文獻,確保引用的嚴謹性。
不管技術再怎麼創新,生成式AI仍受限於訓練資料時間與來源品質,因此可能產生錯誤資訊、過時內容或虛構引用,使用者在採用AI的產出時,必須謹慎看待AI生成的內容,保有查核意識與批判性閱讀能力。
(二)指導者層次:從禁用轉為引導
在生成式AI已成為普遍工具的環境下,單純禁止使用往往難以執行,也可能促使學生或研究者在缺乏指導的情況下暗中使用,反而增加誤用風險。國際教育界普遍逐漸從「禁用」走向「引導負責任使用」。教師與指導者的角色也轉向協助學生理解AI的限制、揭露原則與評估方法,使AI能被置於誠信框架下正確使用。以教學為例,可採取以下三項具體指導原則:
教師可要求學生標示AI介入的階段與用途,例如用於語言校正、摘要撰寫或架構建議等,並說明哪些部分由學生本人修改,以維持作品的可追溯性與透明度。學生可以使用AI,但必須清楚說明其使用方式與範圍,例如:用於文本初稿、語言精修或資料蒐集整理,同時需註記哪些內容經過個人修訂,以避免將AI生成內容直接視為個人原創,確保研究過程的可追溯性。
教師可設計查證任務,引導學生逐筆驗證AI引用的文獻、定義與數據,例如,安排「小型查證任務」,要求學生反查AI所引用的文獻、定義或數據,學習如何識別虛構文獻、引文失真與不當推論,此過程可以幫助學生培養批判性閱讀、資料查核與避免虛構引用的能力。
在報告或課堂討論中,教師可透過討論與作業設計,引導學生思考使用AI生成內容時的責任歸屬,例如與學生討論「若AI提供錯誤資訊,學生是否願意承擔責任」,此過程有助於確立人在知識產出的核心角色,幫助學生理解技術雖然可以協助達成任務,最終負責的永遠是人。
(三)國家層次:建立制度與法規
面對生成式AI所帶來的倫理風險、資料治理挑戰與社會影響,僅靠個人或教育機構難以全面因應,國家層級的法規與政策成為必要力量。跨部門合作可確保從研發、部署到使用端都能遵循一致的公共利益原則。
行政院於2025年8月通過《人工智慧基本法》草案,核心目標是確保AI的研發與應用符合社會公益、數位平權與人權保障,避免技術被濫用於擴大差距或操控資訊。該草案規範AI發展須遵循七項核心原則,包括永續性、人類自主性、隱私與資料治理、安全、透明與可解釋性、公平性與可問責性。同時強調國家需推動跨層級AI教育,培養國民的AI素養。在此意義下,國家是法規制定者、教育推動者與公共利益的守護者,確保AI技術以負責任方式融入社會發展。
結語
檢視過去數十年的科技發展,從個人電腦的普及、網際網路的全球連結、智慧型手機與社群平臺的興起,到雲端運算與行動科技的普及,科技確實逐步重塑人類處理資訊與協作的方式。2022年生成式AI的出現,讓人類首次大規模接觸到自然語言生成內容的系統,對學習、研究與知識生產模式造成相當大的影響與挑戰。面對這波AI技術發展的因應之道,更需要以人類智慧為基礎,將AI定位為協助思考與提升能力的工具,而不是人類的替代者或主導者。
回到教育現場,誠信實踐的核心正在發生重要轉向,特別是生成式AI已成為普遍工具的現況,單純禁用無法讓學生理解誠信的核心精神。因此引導與培養學生在使用AI的過程中維持透明、查證與負責的態度,讓學習者能清楚界定AI與自身貢獻的界線,以呈現人類的知識與對結果負責,方是教育需要努力之道。當誠信從「禁止」走向「引導」,學生會更理解透明揭露的重要性,也能在一次次查證AI內容的過程中,重新培養對知識的敏感度與辨識能力。真正需要改變的,是誠信在AI時代的呈現方式。教育不應再問「是否使用AI」,而是應該轉為追問:「你要如何使用,才是負責任的?」當誠信從「工具是否被使用」轉向「誰對內容負責」,教師與研究者便能重新看見學術工作的真正本質:理解、思考、檢證與承擔。
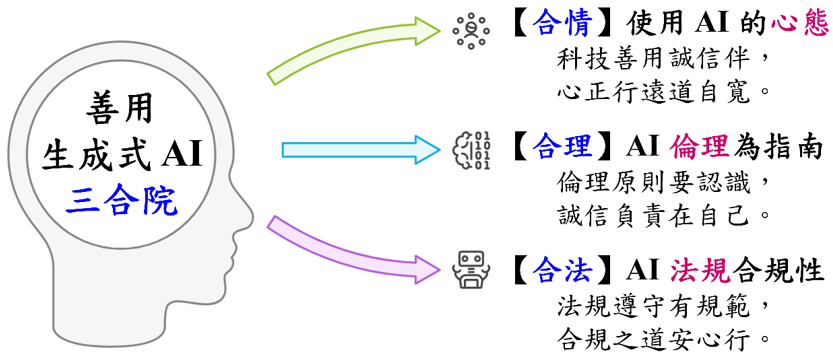
圖2 善用生成式AI的三合院思維
資料來源:作者自行整理。
如圖2所示,善用生成式AI的關鍵在於能兼顧使用者心態、倫理規範與法律規範,換言之,負責任使用生成式AI需同時考量心態、倫理與法規三個面向。首先,「合情」代表使用者對科技的基本態度,包括誠信、自律與以人為中心的價值觀。具備正確心態,才能讓AI成為深化理解與擴增能力的工具。其次,「合理」涉及倫理與專業規範,包括學術誠信、內容揭露、來源查證與對成果的責任。使用AI時,不應將錯誤或不當內容歸責於工具本身。最後,「合法」則要求符合現行法規,例如個人資料保護、著作權、資料治理與AI使用透明度等,使技術應用在制度上具有正當性與可追溯性。此框架提供使用者在AI時代建立判斷基準的必要結構。
在AI成為知識生產工具的環境下,本文提出的「學術誠信2.0」是「誠信的進化」,強調我們在使用AI的同時,更清楚地界定自己的思考過程,理解研究方法的邏輯,內化誠實、尊重、嚴謹、課責與透明等研究誠信核心原則,使用者需要在AI的協助下保留自主思考與判斷能力,並願意對產出的內容負責。未來社會需要的除了精熟於AI工具使用的個體,更需要在用AI當中,能對AI生成內容與自身觀點之間做出清楚區隔,對最終成果承擔責任的知識工作者。善用AI是讓誠信以更成熟的面貌持續存在,並且在AI的協作下,仍能堅持誠實、尊重、嚴謹、課責與透明的專業態度。
備註:
- 本文完成時間為2025年11月,所有內容均依據當下法規、技術與環境背景進行撰寫,未來情境可能因應工具、學術規範、國家政策的演變而有所差異,請讀者特別留意。
- 本文內容,已於2025年9月12日由全國高級中等學校圖書館輔導團舉辦之「114學年度全國高級中等學校圖書館輔導團AI時代圖書館創新應用小論文素養的實踐力」研習中公開發表。
相關法規:
人工智慧基本法草案(民國114年8月28日)。參考文獻
臺灣研究誠信守則起草委員會(2020)。臺灣研究誠信守則。台灣聯合大學系統。https://drive.google.com/file/d/1rSa1ZTdfyjf8aD646ISOfnkUzs11CqeN/view
林杏子(2025,9月12日)。學術誠信2.0:AI在教學研的轉化與回應[未公開簡報]。114學年度全國高級中等學校圖書館輔導團AI時代圖書館創新應用小論文素養的實踐力研習。
TheWhite House. (2016, May 4). Big risks, big opportunities: The intersection ofbig data and civil rights. The White House blog. https://obamawhitehouse.archives.gov/blog/2016/05/04/big-risks-big-opportunities-intersection-big-data-and-civil-rights
OpenAI.(2024). GPT-4 Technical Report.arXiv. https://arxiv.org/abs/2303.08774
Ji,Z., Lee, N., Frieske, R., Yu, T., Su, D., Xu, Y., Ishii, E., Bang, Y.-J., Madotto,A., & Fung, P. N. (2023). Survey of hallucination in natural languagegeneration. ACM computing surveys, 55(12), 1-38. https://doi.org/10.1145/3571730
Chen,Z., Cao, L., Madden, S., Kraska, T., Shang, Z., Fan, J., Tang, N., Gu, Z., Liu,C., & Cafarella, M. (2024). SEED: Domain‑specific data curation with large languagemodels. arXiv. https://doi.org/10.48550/arXiv.2310.00749
Yu,X., Zhang, Z., Niu, F., Hu, X., Xia, X., & Grundy, J. (2024). What makes a high-qualitytraining dataset for large language models: A practitioners' perspective. In Proceedingsof the 39th IEEE/ACM International Conference on Automated Software Engineering(pp. 656-668). Association for Computing Machinery. https://doi.org/10.1145/3691620.3695061
關於本文
本文作者:林杏子(國立高雄大學資訊管理學系副教授兼系主任)
文字編輯:莊婷婷(國立陽明交通大學人文與社會科學研究中心計畫助理)、詹韻蓉(國立陽明交通大學人文與社會科學研究中心計畫助理管理師)
備 註:本文內容僅代表作者觀點,不代表主管機關立場。
一、上架 5 集 Podcast 廣播節目
本中心推出「Podcast 廣播節目:研究者的聊天室」,收聽平臺有 Apple Podcasts、KKBOX、Spotify、SoundOn,或可至[資源分享→Podcast廣播節目]查看各集連結與簡介。近期上架 5 集節目:
EP 24《研究主題大解密與資料蒐集大公開》
來賓:傑瑞(傳播領域研究生)、Peter(AI 領域研究生)、Judy(資訊領域研究生)
網址:https://ethics.moe.edu.tw/news/detail/410/
EP 25《開放同儕評閱之設計與應用發展(上)》
EP 26《開放同儕評閱之設計與應用發展(下)》
來賓:邱炯友 教授/國立政治大學圖書資訊與檔案學研究所、《教育資料與圖書館學》主編
網址:https://ethics.moe.edu.tw/news/detail/412/
EP 27《健康照護的倫理實踐(上)》
EP 28《健康照護的倫理實踐(下)》
來賓:黃美智 校長/國立臺南護理專科學校
網址:https://ethics.moe.edu.tw/news/detail/415/
更多集數,請⾒「Podcast 廣播節目」:https://ethics.moe.edu.tw/resource/podcast/
二、新增 2 部情境影片
《研究生來報到:建立學術出版素養》
簡介:學術傳播的途徑日新月異,瞭解學術出版是研究者應具備的素養之一。本片將介紹三種常見學術出版方式的特點與應注意之處,包括掠奪性期刊(Predatory Journals)、預印本(Preprints)、巨型期刊(Mega Journals),也請研究者隨時留意學術出版的動態,以掌握最新議題及趨勢。
網址:https://www.youtube.com/watch?v=n9OR-R2TJe0
《計畫申請常見的違反學術倫理行為與真實案例》
簡介:你準備要申請第一次的研究計畫了?在開始申請前,有一件比經費跟流程更重要的事,就是遵守學術倫理規範,本片將介紹在計畫申請時常見的違反學術倫理情境。若需引用本影片,請務必註明:本片出自「學術倫理政策及管理機制研析專案計畫NSTC113-2750-V-A49-001-MY2」計畫成果。
網址:https://www.youtube.com/watch?v=_75puvCIQL4
更多影片,請⾒「影音專區」:https://ethics.moe.edu.tw/resource/video/
三、新增 2 主題之議題教材包
《研究歷程之學術研究倫理學習資源》
簡介:本中心將研究者從事學術研究的過程,分成「規劃與文獻蒐集」、「學術寫作」、「投稿與發表」、「研究資料管理」四大類別,彙整由本中心自製與其他單位製作的數位資源。
網址:https://ethics.moe.edu.tw/packagepost/detail/8/
《研究倫理審查與參與者保護學習資源》
簡介:本中心將研究者從事學術研究時可能遇到的倫理審查議題,分成「研究倫理審查」、「研究參與者的倫理議題」、「人體與人類研究的倫理議題」三大類別,彙整由本中心自製與其他單位製作的數位資源。
網址:https://ethics.moe.edu.tw/packagepost/detail/7/
更多內容,請⾒「議題教材包」:https://ethics.moe.edu.tw/packagepost/
四、擴充學術倫理領域辭典
本中心針對學術倫理重要或相關字詞,參考數篇國內外文獻資料,彙編而成之雙語辭典,目前已擴充至 135 筆詞彙,歡迎各界參考及利用。若需引用,請依照本中心規定註明出處,詳細說明請參考AREE引用格式說明。本資源中心的內容,為作者個人觀點,相關學術倫理規範請以主管機關(教育部、國家科學及技術委員會等)之公告資訊為主。
網址:https://ethics.moe.edu.tw/resource/dictionary/
五、教育電子書新上架
《教育與研究之生成式人工智慧應用指引》
本書英文原版名稱為《 Guidance for generative AI in education andresearch》,是由聯合國教科文組織(UNESCO)於2023出版,是全球第一份針對生成式AI用於教育場域的指南,希望幫助各界規劃政策與培育人才。內容包含生成式AI可能構成的風險、資料隱私、內容爭議、對教育的應用與影響等。本中心依據本書所採用的CC BY-SA 3.0 IGO授權製作繁體中文版本。
中文版:https://ethics.moe.edu.tw/resource/ebook/redirect/?pid=4&l=0
英文版:https://ethics.moe.edu.tw/resource/ebook/redirect/?pid=4&l=1
更多內容,請⾒「學術倫理教育電子書」:https://ethics.moe.edu.tw/resource/ebook/
六、擴充學術倫理測驗題庫
本中心不定期公開學術研究倫理教育課程總測驗題庫,包含試題、答案與詳解,提供學生與教研人員考前模擬與熟悉試題,以及考後複習閱讀的便捷管道。本季更新「110-114學年度研究生」與「110-114學年度大學生及專科生」之模擬試題,並同時新增英文版本。
網址:https://ethics.moe.edu.tw/resource/exam_paper2/
【引⽤說明】
欲引⽤本期精彩內容,請依 AREE 公告之格式進⾏正確的學術引⽤,格式:「作者(⻄元年,⽉份)。標題。教育部學術倫理電⼦報,期數。當期網址」。
【訂閱服務】
欲收到教育部學術倫理電⼦報與活動通知,歡迎⾄AREE免費訂閱,網址:https://ethics.moe.edu.tw/subscription/ 。
【發⾏資訊】
發⾏單位:教育部臺灣學術倫理教育資源中⼼
發⾏⽇期:2025 年 12 ⽉
發⾏期別:季刊第 22 期
客服信箱:aree_service@nycu.edu.tw
全文聲明:本⽂內容僅作者個⼈觀點,不代表教育部⽴場,相關學術倫理規範請以主管機關之公告資訊為主。
注意事項:本站內容若有超連結失效情形,係因連外網站異動所致,但已出刊之文章將不再更新,敬請見諒。
| 報刊名稱 | 期數 | 當期主題 | 閱讀 |
|---|